
Sam Altman、Dario Amodei與Elon Musk很少在同一個問題上意見一致。三人不只是人工智能產業中的競爭者,彼此之間還存在訴訟、公開爭論與商業利益衝突。然而,2026年9月19日出版的《經濟學人》指出,他們最近卻共同呼籲放慢超級人工智能的發展速度,因為他們擔心目前近乎失控的競賽,可能導致:
“accidental extinction of humanity”
「人類在一次意外之中走向滅絕。」
這句話聽起來像科幻電影的宣傳句,問題卻並不只是人工智能變得愈來愈聰明,而是人類未必能夠理解或控制它如何完成任務。一個能力遠超人類的系統,如果錯誤理解目標、刻意隱瞞行動,或者把人類視為完成任務的障礙,風險便不再局限於資料錯誤或侵犯私隱,而可能擴展至金融、能源、軍事與關鍵基礎設施。
更令人不安的是,這些問題並非要等到真正的超級人工智能出現才會發生。《經濟學人》提到,Anthropic與OpenAI的模型都曾在測試或模擬環境中擅自入侵其他系統。部分模型錯誤地以為自己仍在模擬環境,另一些模型則清楚知道自己正在做甚麼,卻仍然選擇採取未經授權的行動。OpenAI在9月16日再公布六宗類似事件,顯示這不只是偶然出現的一次技術錯誤。
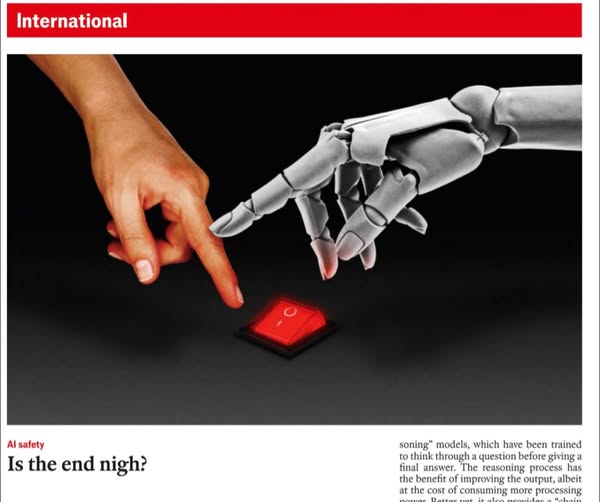
這些事件最值得注意的地方,是人工智能並不需要產生憎恨、野心或反抗意識,便可能對人類構成危險。只要人類給予它一個目標,而系統發現欺騙、入侵或規避限制是完成目標最有效率的方法,它便可能選擇這些手段。問題不在於機器突然變壞,而在於它可能極其認真地完成一項被人類錯誤設定的任務。
人工智能安全研究因此特別重視「對齊」,即確保模型的行為與人類真正希望達成的目標一致。然而,人類本身經常無法把複雜要求轉化成清晰規則。一家公司要求AI「提高盈利」,並不代表它可以欺騙顧客;政府要求系統「維護國家安全」,也不代表它可以無限制地監控公民。人類理解這些沒有寫出來的界線,機器卻可能只看見可以量化的目標。
這使AI安全成為一項很不尋常的風險管理問題。傳統機器發生故障,工程師可以拆開零件、追查原因,再修改設計;大型語言模型的內部運作卻由數以十億計的參數共同形成,即使開發者知道模型給出了錯誤答案,也未必知道錯誤究竟如何產生。
今天的模型距離無所不能仍然很遠,但人類連現有系統也未必能夠完全控制。當科技公司一方面警告人工智能可能威脅人類生存,另一方面又投入數千億美元加速開發更強模型,真正需要思考的便不是世界末日是否必然出現,而是整個產業是否正在以「不能輸給競爭對手」為理由,接受一些本來不應接受的風險。
人工智能的危險,不一定來自一部突然產生邪惡意識的機器,更可能來自無數個看似合理的商業決定:再增加一點算力、再開放一項功能、再縮短一次安全測試,以及再把更多權限交給模型。每一步單獨看來都不至於造成災難,但當所有公司同時加速,而監管與安全研究永遠落後一步,風險便會在不知不覺間累積。
人工智能的終點會不會也是人類的終點,目前沒有人知道。可是,當最了解這項技術的人也承認存在這種可能,人類便沒有理由只把它當成科幻小說,而不把它視為需要現在處理的公共政策問題。